

纽大教授警告:AI正在偷走你的研究
 2026-09-29
 4897
一个过去很多科研人员不会认真考虑的问题,这几天突然被摆到了桌面上:如果你把一个还没发表、甚至还没有写成论文的科研idea拿去和AI讨论,这个想法还完全属于你吗?
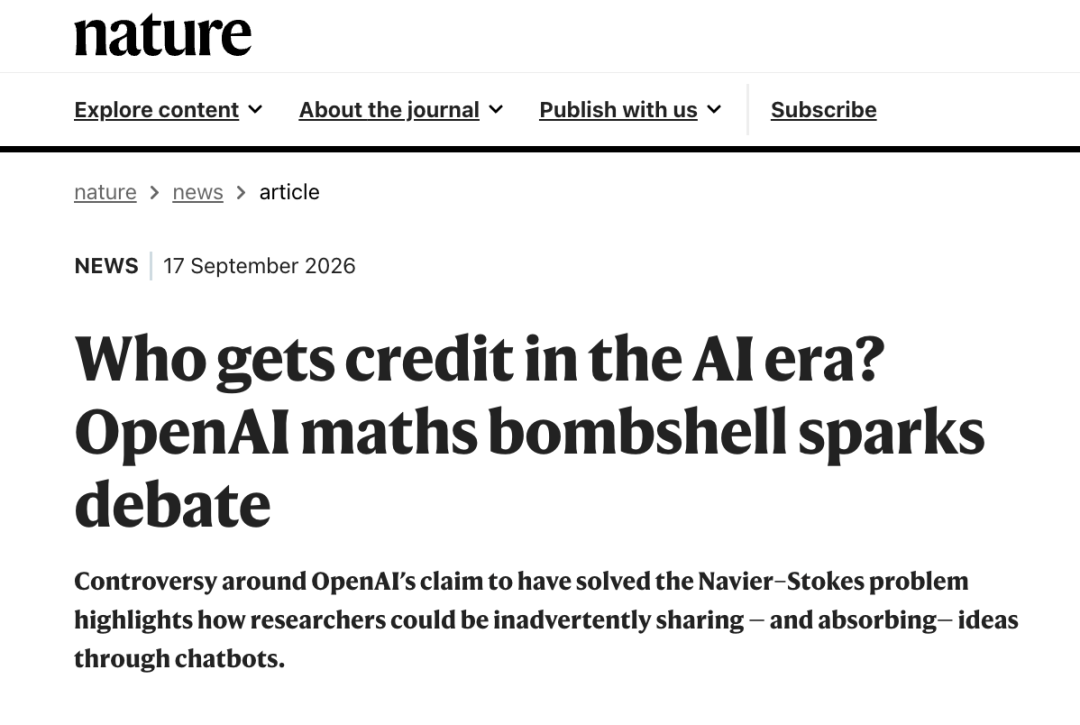
事情起因于数学界最近的一场风波。9月8日,OpenAI宣布,其内部AI系统给出了Navier–Stokes千禧年难题的一项解答。这个问题已经困扰数学界近90年,OpenAI称大约1万个协同AI智能体参与了求解,并同时给出了数学证明和Lean形式化验证。公司表示,这项工作是9月1日才启动的。
偏偏就在这之前,纽约大学数学家Tristan Buckmaster和合作者Levent Alpöge也一直在沿着相关方向推进研究。他们已经在一个与Navier–Stokes密切相关的强迫Euler方程问题上取得突破,而且研究过程中并没有把AI当作普通的文字工具,而是长期使用OpenAI和Anthropic的模型帮助推导、验证和讨论数学问题。Buckmaster随后提出了一个让很多科研人员都警觉起来的问题:自己过去输入AI的那些尚未发表的思路,会不会在某种意义上进入模型,又在后来被用于解决相同或者相近的问题?
这个怀疑目前没有证据证明成立。OpenAI随后专门进行调查,并向《Nature》回应称,可以确认7月3日以后用户输入的内容不可能以任何方式影响此次使用的系统;公司也表示,团队直到9月1日才开始研究Navier–Stokes问题,在Buckmaster和Alpöge公开成果以前,没有通过任何渠道看到他们的研究。OpenAI后来还在自己的官方说明中补充,Buckmaster在公告前两个月输入Codex的提示不可能通过训练影响这个内部模型。
问题因此并没有变成一次已经坐实的“AI窃取科研成果”事件。真正让数学界不安的,是Buckmaster透露的另一个细节:他过去一年一直使用OpenAI工具研究这一问题,一共有三个ChatGPT账户,其中只有两个账户关闭了允许聊天内容用于模型训练的设置。换句话说,至少在一部分时间里,他自己并没有完全切断研究讨论被用于模型改进的可能性。
这件事随后让《Nature》专门发文讨论了一个越来越现实的问题:AI已经从写摘要、改英文,走到了和科研人员一起推公式、找假设、设计实验、分析数据的阶段,但学术界关于“未公开思想进入AI以后怎么算”的规则几乎还没有跟上。 人与人之间做科研,如果一个数学家从另一个人的办公室讨论中获得了重要思路,正式论文里通常至少要致谢;但如果这个“听到想法的人”变成了一个聊天机器人,后来另一套AI系统又得出了类似结果,这个思想的来源怎么证明、怎么追踪、又该不该署名或致谢,目前都没有成熟答案。
而且Buckmaster并不是唯一一个提出这种担忧的人。德国数学家Andreas Thom也告诉《Nature》,他过去一年曾经用ChatGPT讨论群论中的一个长期开放问题,并尝试构造一种此前没有找到的non-sofic group。今年8月,OpenAI发表的一篇预印本恰好用到了与他探索方向相近的策略。Thom同样没有证据证明自己的聊天内容被模型利用,OpenAI也没有确认这一点,但他认为问题恰恰就在这里:即使真的发生过思想传递,现在也很难追溯。
对于普通科研人员来说,这件事真正值得注意的地方,可能不是OpenAI究竟有没有使用这两位数学家的工作,而是我们已经开始把过去只会放在实验室、课题组会议、私人邮件里的内容,大量交给AI。一个尚未申请专利的技术路线、一套刚跑出来但没有发表的数据、一个博士生刚想出来的实验设计、一篇还在匿名审稿的论文,过去都会被视为需要谨慎控制传播范围的信息,现在却很容易因为“让AI帮我看看”而直接粘贴进去。
按照OpenAI目前公开的数据规则,个人版ChatGPT和Codex在相应设置开启时,用户提交的内容可能被用于改进模型;用户可以在设置中关闭“Improve the model for everyone”,关闭之后新的对话不会用于训练。Temporary Chat也不会用于改进模型。Business、Enterprise、Edu以及API等商业产品则默认不使用客户输入输出训练通用模型。
所以,“AI正在偷走你的研究”目前不能理解成AI公司已经被证明在系统性窃取科研成果。更准确地说,一个新的科研风险已经出现了:过去科研人员最担心的是别人看到自己的未发表成果,现在还要多问一句——我把这个想法告诉AI之后,究竟会发生什么?
这场Navier–Stokes争议最终也许会证明双方的研究完全独立,但它已经留下了一个很难再忽视的问题。AI越像一个真正的科研合作者,科研人员就越不能再把它只当成一个没有记忆、没有数据流向、也不存在知识归属问题的计算器。对于真正具有原创价值、尚未发表的研究,至少在把它完整交给AI之前,研究者可能需要先弄清楚:这个账户的数据设置是什么,这些内容会不会进入训练,以及一旦未来发生成果归属争议,自己还能不能证明这个想法最早来自哪里。